GUI Agent · Multimodal Post-training · Agent Systems
吴高
浙江大学控制科学与工程学院 · 2027 届硕士研究生
本科就读于西北工业大学自动化专业,保研至浙江大学。研究围绕 GUI Agent 和大模型后训练,关注智能体如何在长程、动态的真实环境中稳定执行任务,并从交互中持续学习。
- 教育背景
- 西北工业大学 → 浙江大学(保研)
- 产业经历
- 快手 → 阿里巴巴通义实验室
- 研究产出
- 3 篇第一 / 共同第一作者论文
从“如何评测记忆”出发,沿着任务内的短期上下文管理与跨任务的长期经验复用展开研究,再进一步探索:Agent 能否通过自己的探索与反馈完成策略优化?
Industrial experience
实习经历:把算法能力放进真实系统
01
2026.06.22 – 2026.09.17
阿里巴巴通义实验室
AI 研发实习生 · Qwen 后训练数据生成 · 移动端 GUI 方向负责移动端 GUI 训练数据生成方向,承担多基准环境接入与多配置 Rollout 方案设计。以 AndroidWorld 为例,在相同应用环境中接入团队重新设计的训练目标与配套评测,保留原生任务用于验证,形成从任务构建到实际采样的数据链路。
训练任务与评测
接入团队扩展的任务目标与评测脚本,保留原生任务用于验证
多基准环境接入
AndroidWorld、MobileWorld、MobileGym、iOSWorld 等
多配置 Rollout
多模型、多 Agent、多动作空间,丰富行为覆盖与轨迹来源
数据生成闭环
批量执行、自动评测、轨迹回收与失败恢复
设计多模型、多 Agent 与多动作空间采样:接入原生 GUI Agent 与 Claude Code / Codex,通过 MCP 限定 GUI 动作,或开放终端 / ADB 工具。参与任务运行、评测与轨迹回收平台建设,依托平台 4 万级并发与百万级日处理能力支撑规模化数据生成。
02
2025.08.11 – 2026.06.18
快手主站技术部
AI 研究实习生 · 企业级 Android 通用智能回测平台探索如何将 GUI Agent 的通用任务执行能力转化为企业级移动端测试能力,推动算法能力从原型走向真实测试业务。
01页面探索→
02知识沉淀→
03测试执行与验证→
04结果分析
完整经历算法能力抽象、平台方案设计、测试执行与验证,到真实业务落地的全过程。
Research & projects
从记忆评测,到经验复用与策略优化
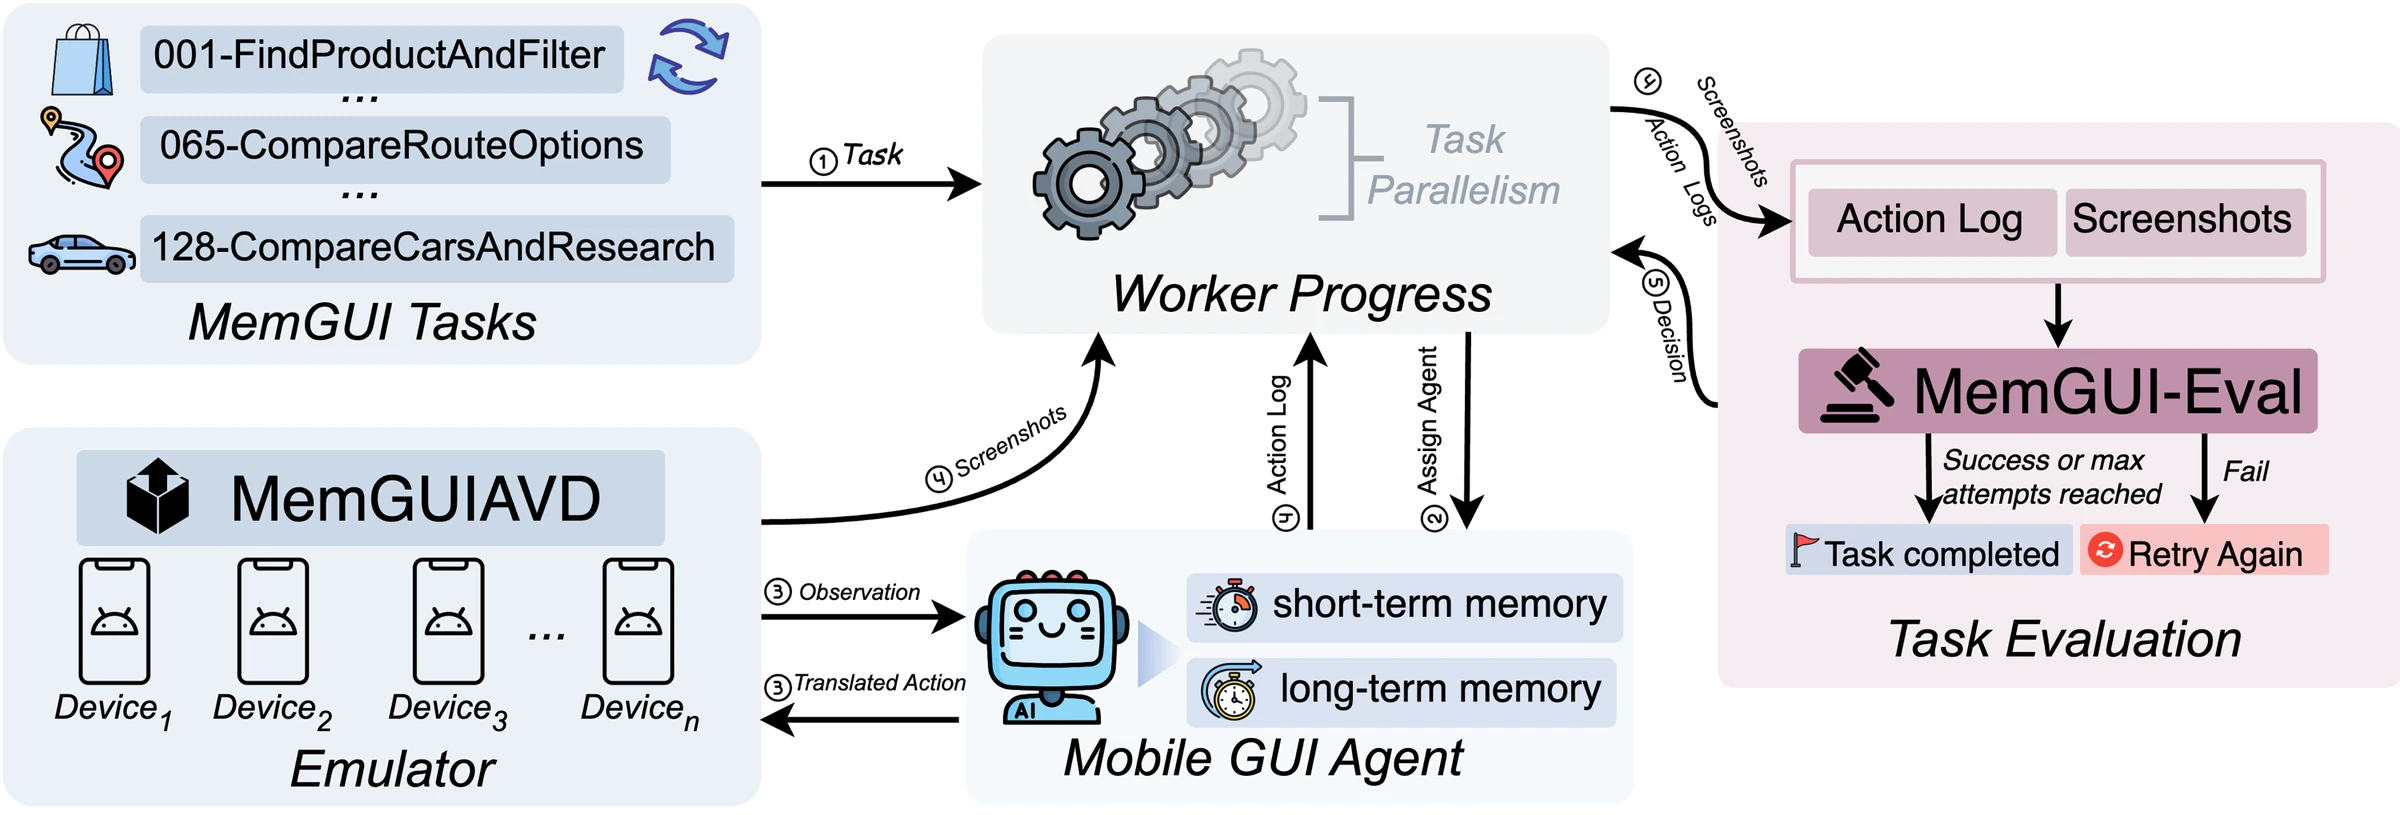
MemGUI-Bench 建立短期与长期记忆的评测视角;MemGUI-Agent 与 STEER 分别探索两个方向;MobileForge 进一步走向反馈驱动的模型后训练。
起点:如何评测 GUI Agent 的记忆能力?
区分任务执行过程中的短期信息保持,以及跨任务、跨轮次复用经验的长期记忆,构建覆盖真实应用与长程操作的记忆评测基准。
- 参与基准建设与长程任务评测分析
- 通过镜像任务与多轮执行观察经验迁移
- 渐进式自动评测定位记忆与跨应用信息使用的瓶颈
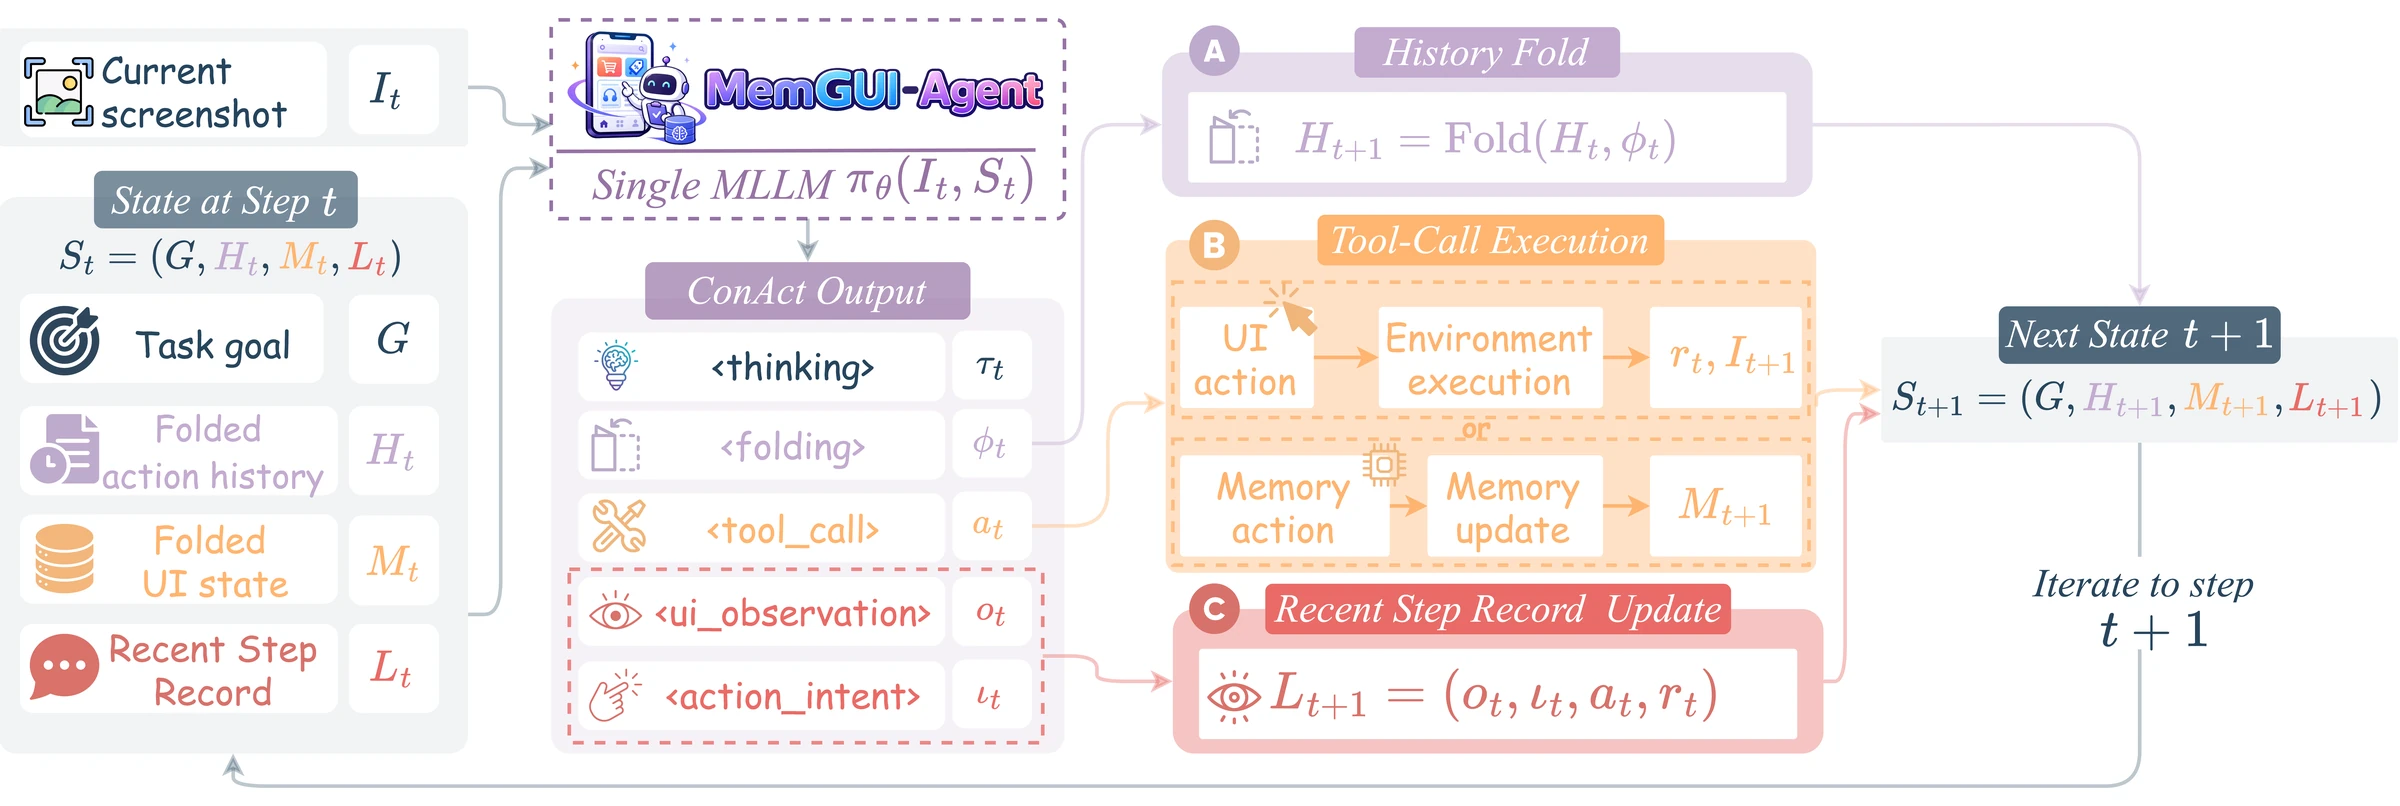
任务内:让模型主动管理上下文
针对 MemGUI-Bench 揭示的短期记忆瓶颈,将上下文管理建模为与 GUI 操作统一生成的动作,使模型自主决定何时压缩历史、更新记忆和保留关键信息。
- 参与主动上下文管理方法设计
- 参与任务扩展、教师轨迹采集与质量过滤
- 基于 Qwen3-VL-8B 完成 LoRA SFT 和泛化评测
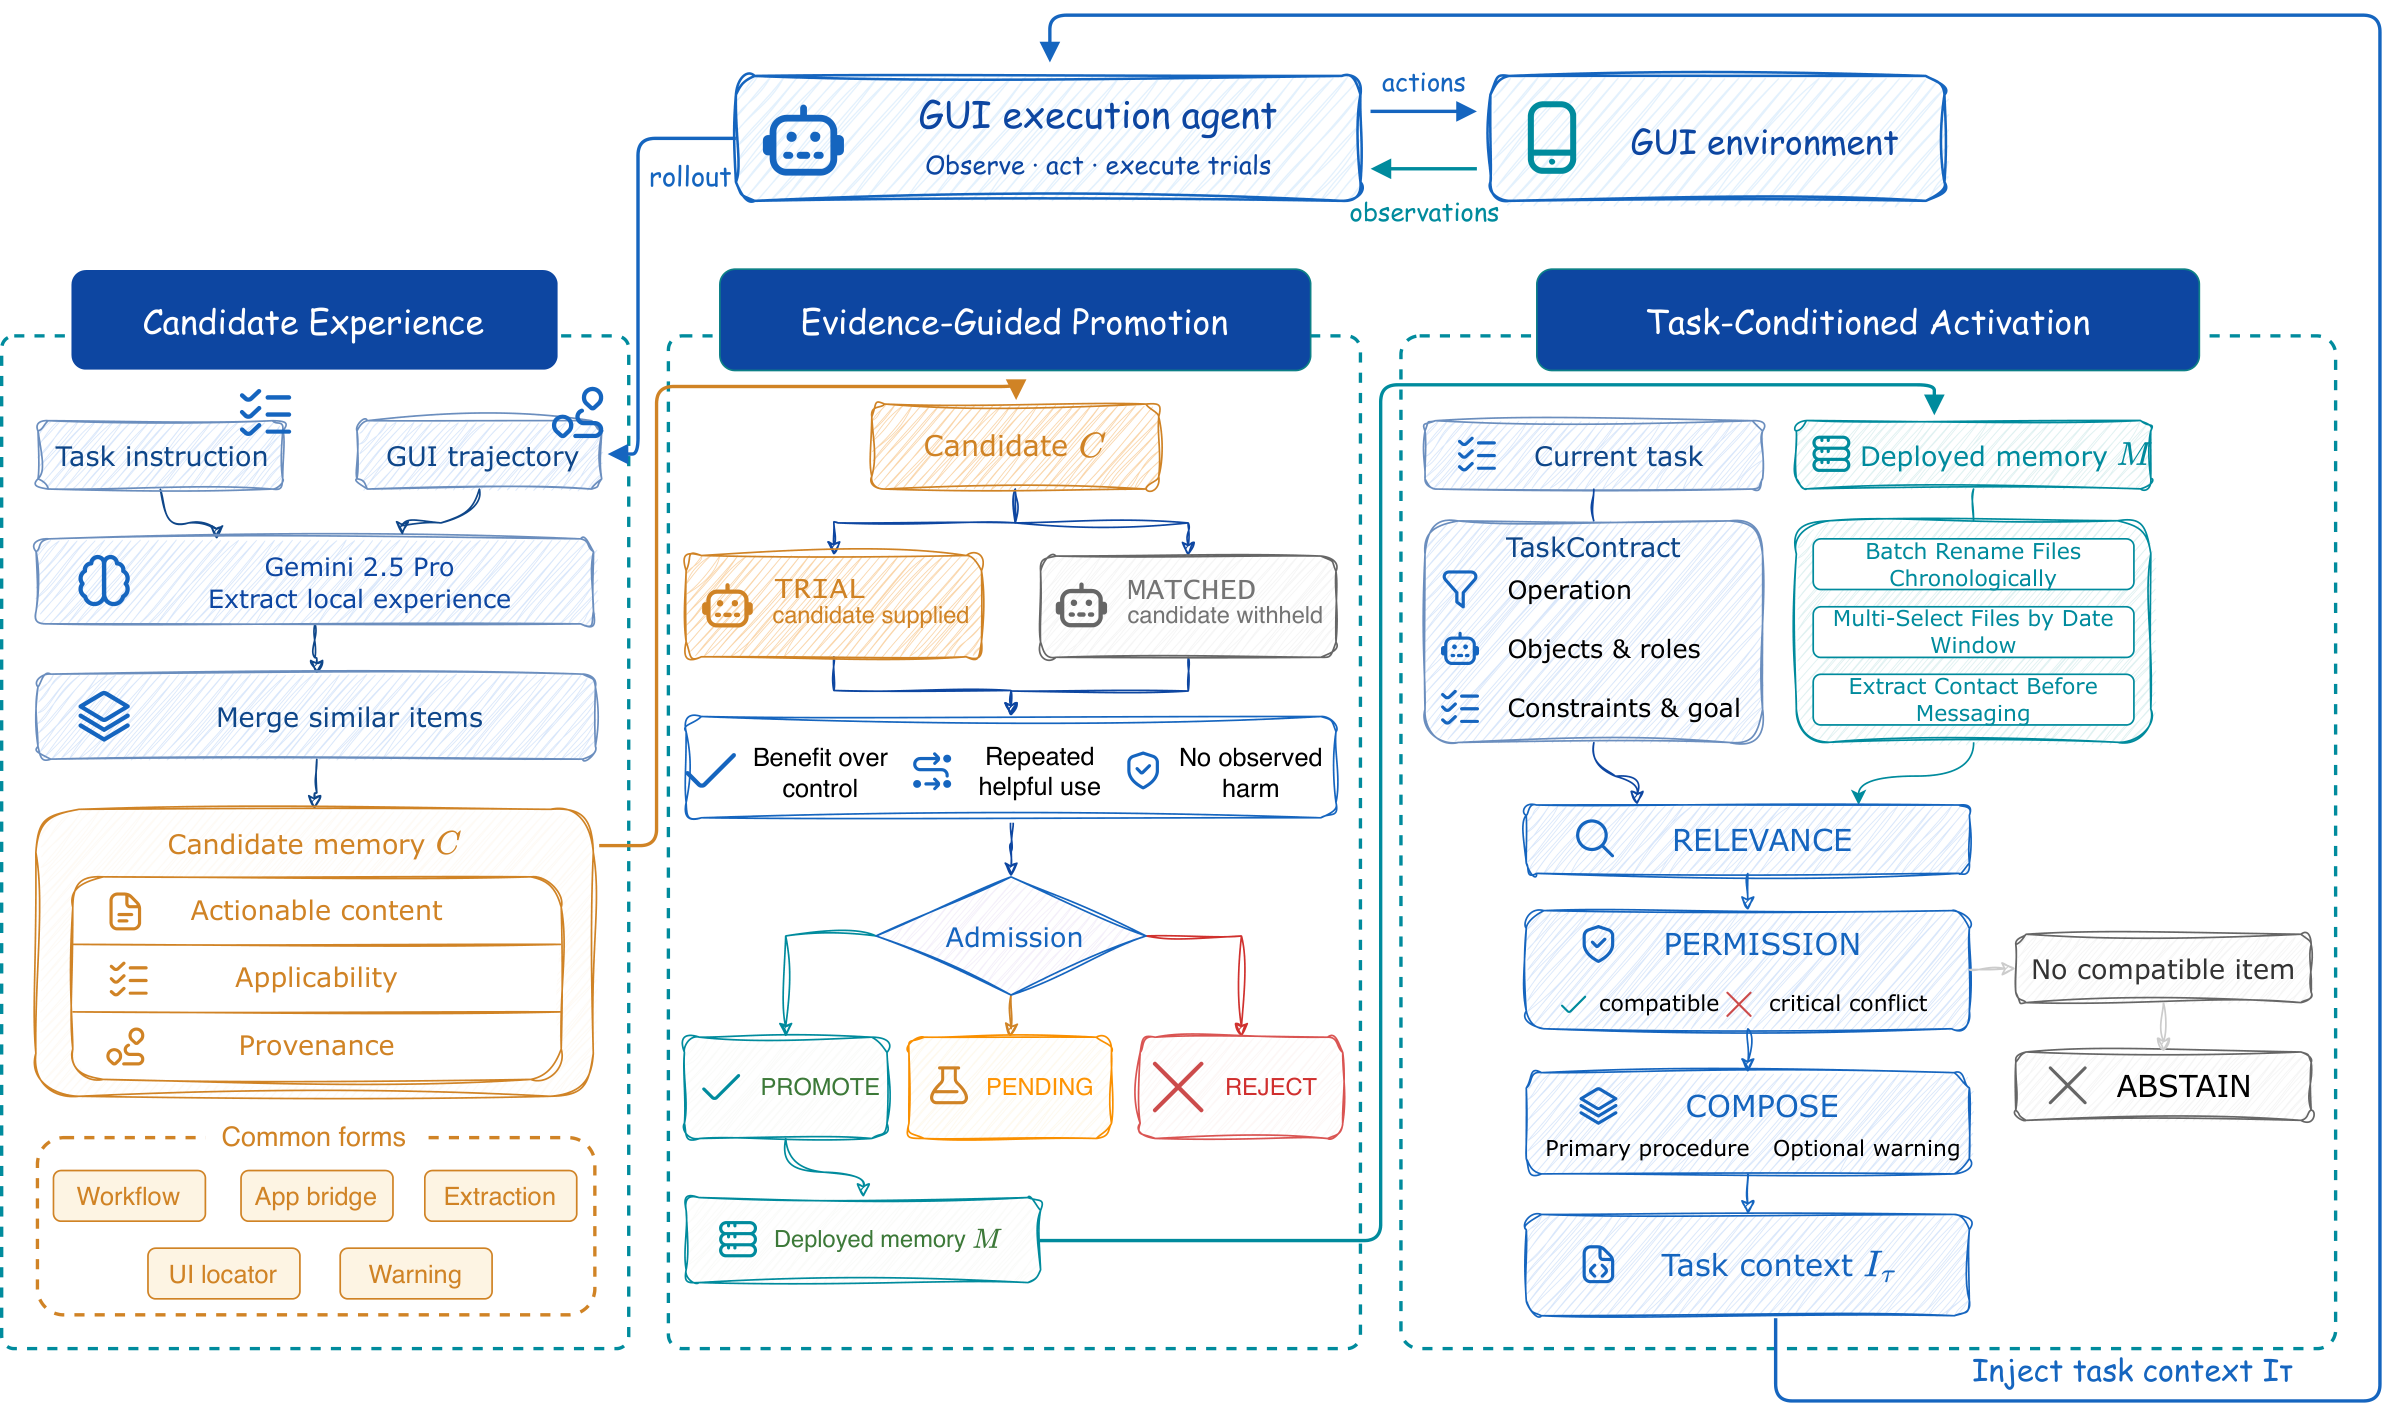
跨任务:把交互经验变成经过验证的操作知识
执行模型保持冻结,通过完整知识生命周期持续学习:经验具有明确适用条件,先经过候选试验与准入,再根据当前任务的操作目标筛选、组合和复用。
- 主导方案设计、系统实现与实验评测
- 结果条件化表示:保留行为、适用条件、完成条件与来源证据
- 受控准入与 TaskContract 选择,过滤操作冲突并组合互补经验
67.5%→77.8%
−70.5%
进一步:通过自己的探索与反馈优化策略
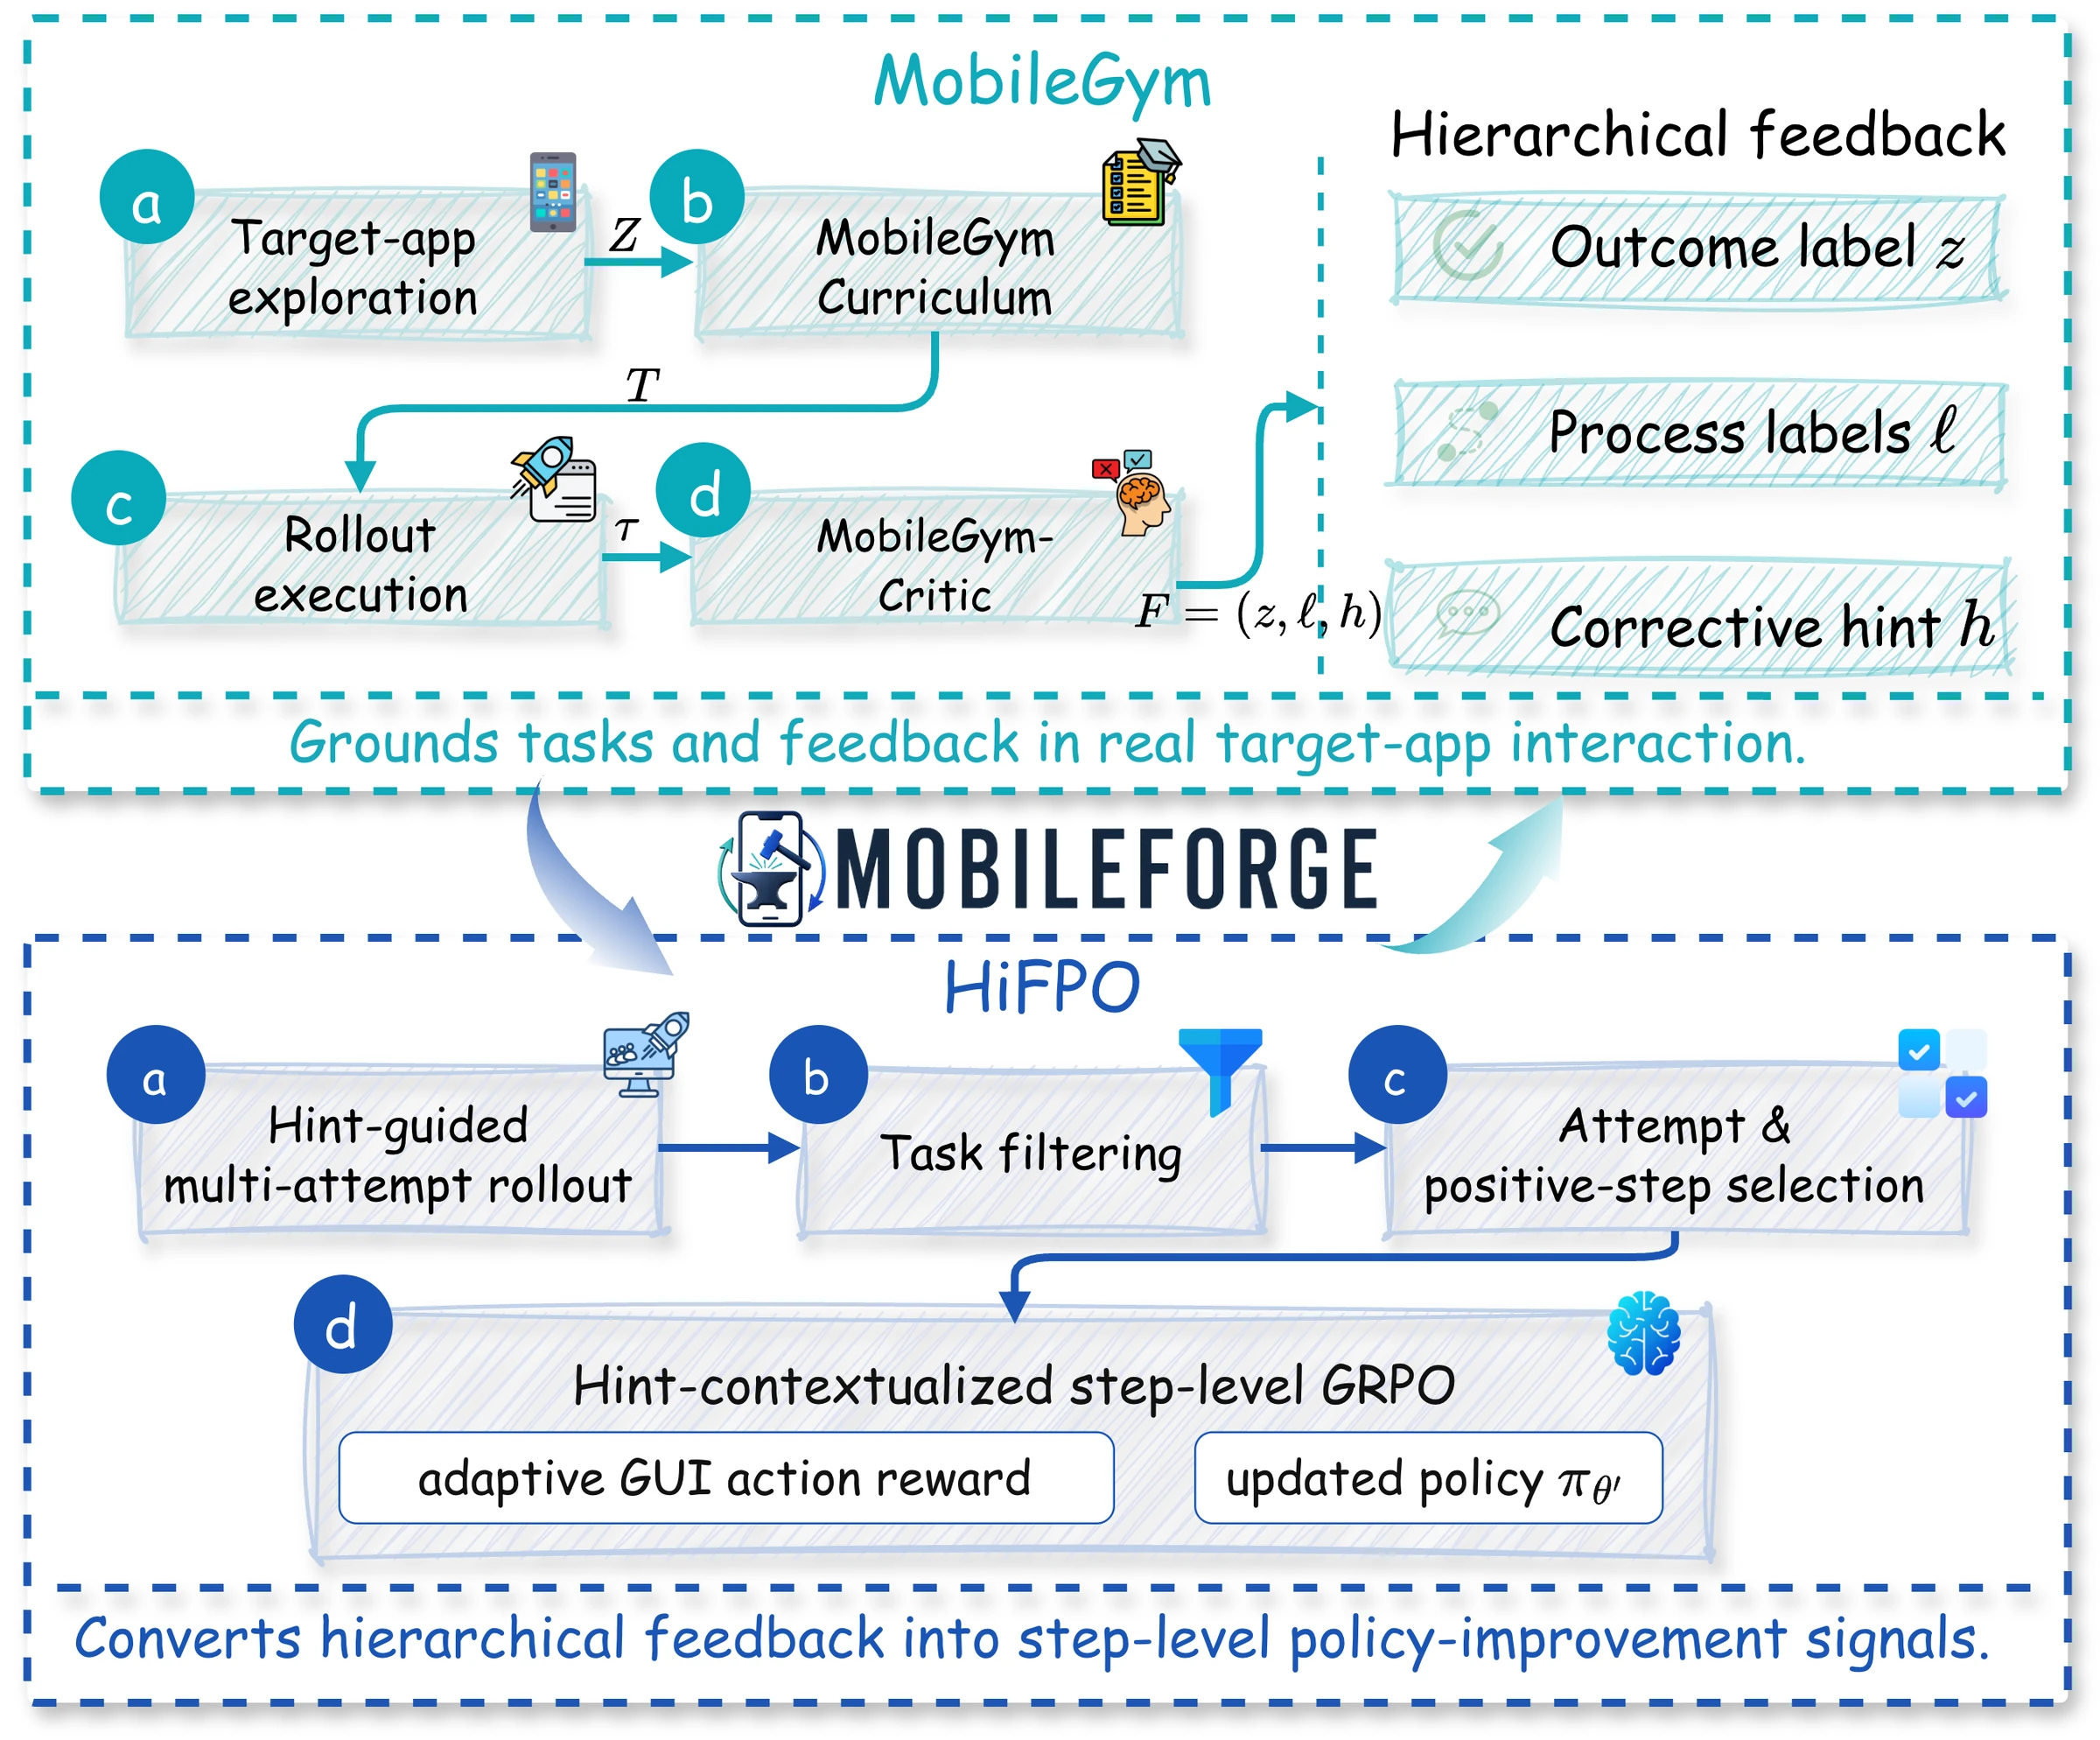
从 MemGUI-Agent 的 SFT 训练出发,进一步研究能否不依赖人工标注轨迹:打通应用探索、任务生成、多轮采样、层级反馈与后训练闭环,将交互经验转化为模型参数中的能力。
- 参与整体方案设计,重点构建交互采样与评测流程
- 参与层级反馈设计,将任务级、步骤级反馈和失败提示转化为 Step-level GRPO 数据
- 基于 VeRL 完成策略优化与系统实验
55.2%→67.2%
69.0%→77.6%
把数据闭环和强化学习迁移到新的大模型任务
负责训练数据构建和模型训练,通过 LoRA SFT、GRPO 以及基于 SQL 执行结果的奖励设计,提升 Qwen3.5-2B 的结构化推理能力。
验证集准确率
38.05%→75.58%
最终名次第 6 名/ 18 支队伍
Selected publications
四篇 GUI Agent 代表作,一条连续研究主线
以记忆评测为起点,分别研究短期上下文与长期经验,再探索无标注的策略优化。
MemGUI-Bench · 记忆评测→MemGUI-Agent / STEER · 短期 / 长期记忆→MobileForge · 策略优化
01共同作者第二作者第一作者共同第一作者
MemGUI-Bench
移动端 GUI Agent 记忆评测基准
不再只测 Agent 会不会点击,而是系统评估它能否跨步骤、跨应用、跨轮次记住并复用信息。
↗02MemGUI-Agent
面向长程任务的主动上下文管理
把“如何管理上下文”变成模型自己输出的动作,让长程 GUI Agent 在控制 Prompt 长度的同时保留关键事实。
↗03STEER
任务条件化的长期经验演化与复用
保持执行模型冻结,把持续交互变成有适用条件、经过试验验证、能够按任务选择复用的操作知识。
↗04MobileForge
无标注移动端 GUI Agent 自进化
让 Agent 在真实目标应用中自己探索、生成任务、获得层级反馈,并把失败经验转化为可训练的策略更新。
↗Why me
我的三项核心优势
完整的 Agent 后训练链路
覆盖任务生成、轨迹采样、评测反馈、LoRA SFT、GRPO 与 VeRL 策略优化。
算法效果与工程落地
兼具企业级测试落地与大规模 Rollout 平台实践,兼顾数据质量、系统稳定性和工程效率。
连续的研究主线
从记忆评测出发,研究短期上下文管理、长期经验复用,再延伸到无标注策略优化。